提示词工程(Prompt Engineering)核心原理与实践(持续更新)
由于本人水平有限,本文仅供简单的入门学习,如果需要深入系统学习,请参考提示工程指南 | Prompt Engineering Guide
提示词工程的本质作用
大语言模型(LLM)本质上是一个"超高维概率拟合器+序列续写机器",从万亿级文本序列中学习next-token概率分布。
其本身并无自主意识、无因果推理,只靠[上下文历史]数学计算,选最贴合人类习惯的下一个字符片段。
Token定义:LLM输入输出的最小单位——不是单个字符,而是高频短词、词根、罕见字符片段等。(主流分词器GPT的BPE/tiktoken)例如:
- 人工智能 → 2~3 Token(“人工”+“智能”具体取决于分词器,也有可能是算1token)
- hello → 1 Token
- supercalifragilisticexpialidocious → 多个Token
- 罕见/生僻字 → 可能被拆成 3-4 个字节级 Token
什么是提示词?
提示词(Prompt)是你与 AI 模型沟通的输入指令。它不仅仅是"问问题",而是精确控制模型行为的编程语言
提示词 = 上下文(Context) + 指令(Instruction) +示例(Examples) + 格式(Format)
提示词的核心组件
| 组件 | 作用 | 示例 |
|---|---|---|
| 角色设定 | 定义模型身份 | “你是一位资深网络安全工程师…” |
| 任务指令 | 明确要做什么 | “请分析这段代码的 SQL 注入漏洞” |
| 上下文 | 提供背景信息 | “这是基于 Python Flask 的后端代码…” |
| 输出格式 | 规定返回结构 | “用 Markdown 表格输出,包含漏洞类型、风险等级、修复建议三列” |
| 约束条件 | 限制行为边界 | “不要提供任何攻击载荷,仅做防御性分析” |
提示词设计的核心原则
① 清晰性(Clarity)
❌ 差:“写个脚本” ✅ 好:“用 Python 编写一个扫描目标网站开放端口的异步脚本,要求使用 asyncio 和 aiohttp,输出格式为 JSON,包含端口号和 banner 信息”
② 具体性(Specificity)
模型不会读心术,你需要把隐式需求显式化。
③ 结构化(Structure)
使用分隔符(如
"""、<xml>标签、Markdown 标题)来组织复杂提示。
④ 少样本学习(Few-shot Learning)
在提示中提供输入-输出示例,让模型"模仿"你的期望格式
请按照以下格式将自然语言转换为 SQL 查询:

输入:查找年龄大于 25 岁的用户
输出:SELECT * FROM users WHERE age > 25;

输入:统计每个部门的平均工资
输出:SELECT department, AVG(salary) FROM employees GROUP BY department;
进阶技巧
- 思维链(Chain-of-Thought, CoT):要求模型"一步一步思考",显著提升推理能力
- ReAct 模式:Reasoning(推理)+ Acting(行动),让模型先思考再执行
- 系统提示 vs 用户提示:系统提示设定全局规则,用户提示处理具体任务
提示工程的形式化框架
很多人把提示词当成"问问题的艺术",但从提示词工程的角度来看,提示词是一门对条件概率分布进行约束的技术。
核心定义
设语言模型为条件概率分布:$P_\theta(Y|X)$
其中:
- $X=(x_1, x_2, …, x_n)$是输入 token 序列
- $Y=(y_1, y_2, …, y_m)$是输出 token 序列
- θ 是预训练好的模型参数(测试时固定不变)
提示(Prompt)是一个映射函数:$X = P(T; C, I, F, E)$
它将你的原始任务描述 T 转换成模型能处理的输入 X:
- C:上下文(Context)
- I:指令(Instruction)
- F:输出格式约束(Format)
- E:示例集合(Exemplars)
为什么提示有效?两个理论视角
贝叶斯视角:示例 E 为模型提供了隐式的任务先验,使后验分布$P_\theta(Y|X)$ 更集中于目标区域。
元学习视角:预训练让模型学会"如何根据提示快速适应新任务",测试时无需更新参数。
提示工程的五级方法
| 层级 | 方法 | 核心机制 | 适用场景 |
|---|---|---|---|
| L0 | Zero-shot | 直接指令,无示例 | 通用知识问答 |
| L1 | Few-shot | k 个输入-输出示例 | 格式敏感任务 |
| L2 | Chain-of-Thought | 引入中间推理步骤 | 数学/逻辑推理 |
| L3 | Self-Consistency | 多路径采样并投票 | 高可靠性推理 |
| L4 | ReAct / Toolformer | 与外部工具交互 | 需要实时信息或精确计算 |
从文字到向量
文字怎么变成数字?
提示词不是"哄"模型,而是在参数不变的前提下,通过输入设计来操控后验概率分布。所有技巧的本质都是:让模型生成你期望输出的概率变得最大。
接下来会较为详细的讲解,模型收到提示词后,内部如何处理?
自然语言是离散的符号系统:词、语法规则、句法树。
但语义是连续的:“国王"和"女王"的相似度,应该介于"国王"和"苹果"之间。
AI 的数学基础——向量(Vectors)
向量是什么?
理解提示词之后,你需要知道:AI 模型内部并不直接处理文字,它处理的是数字——向量
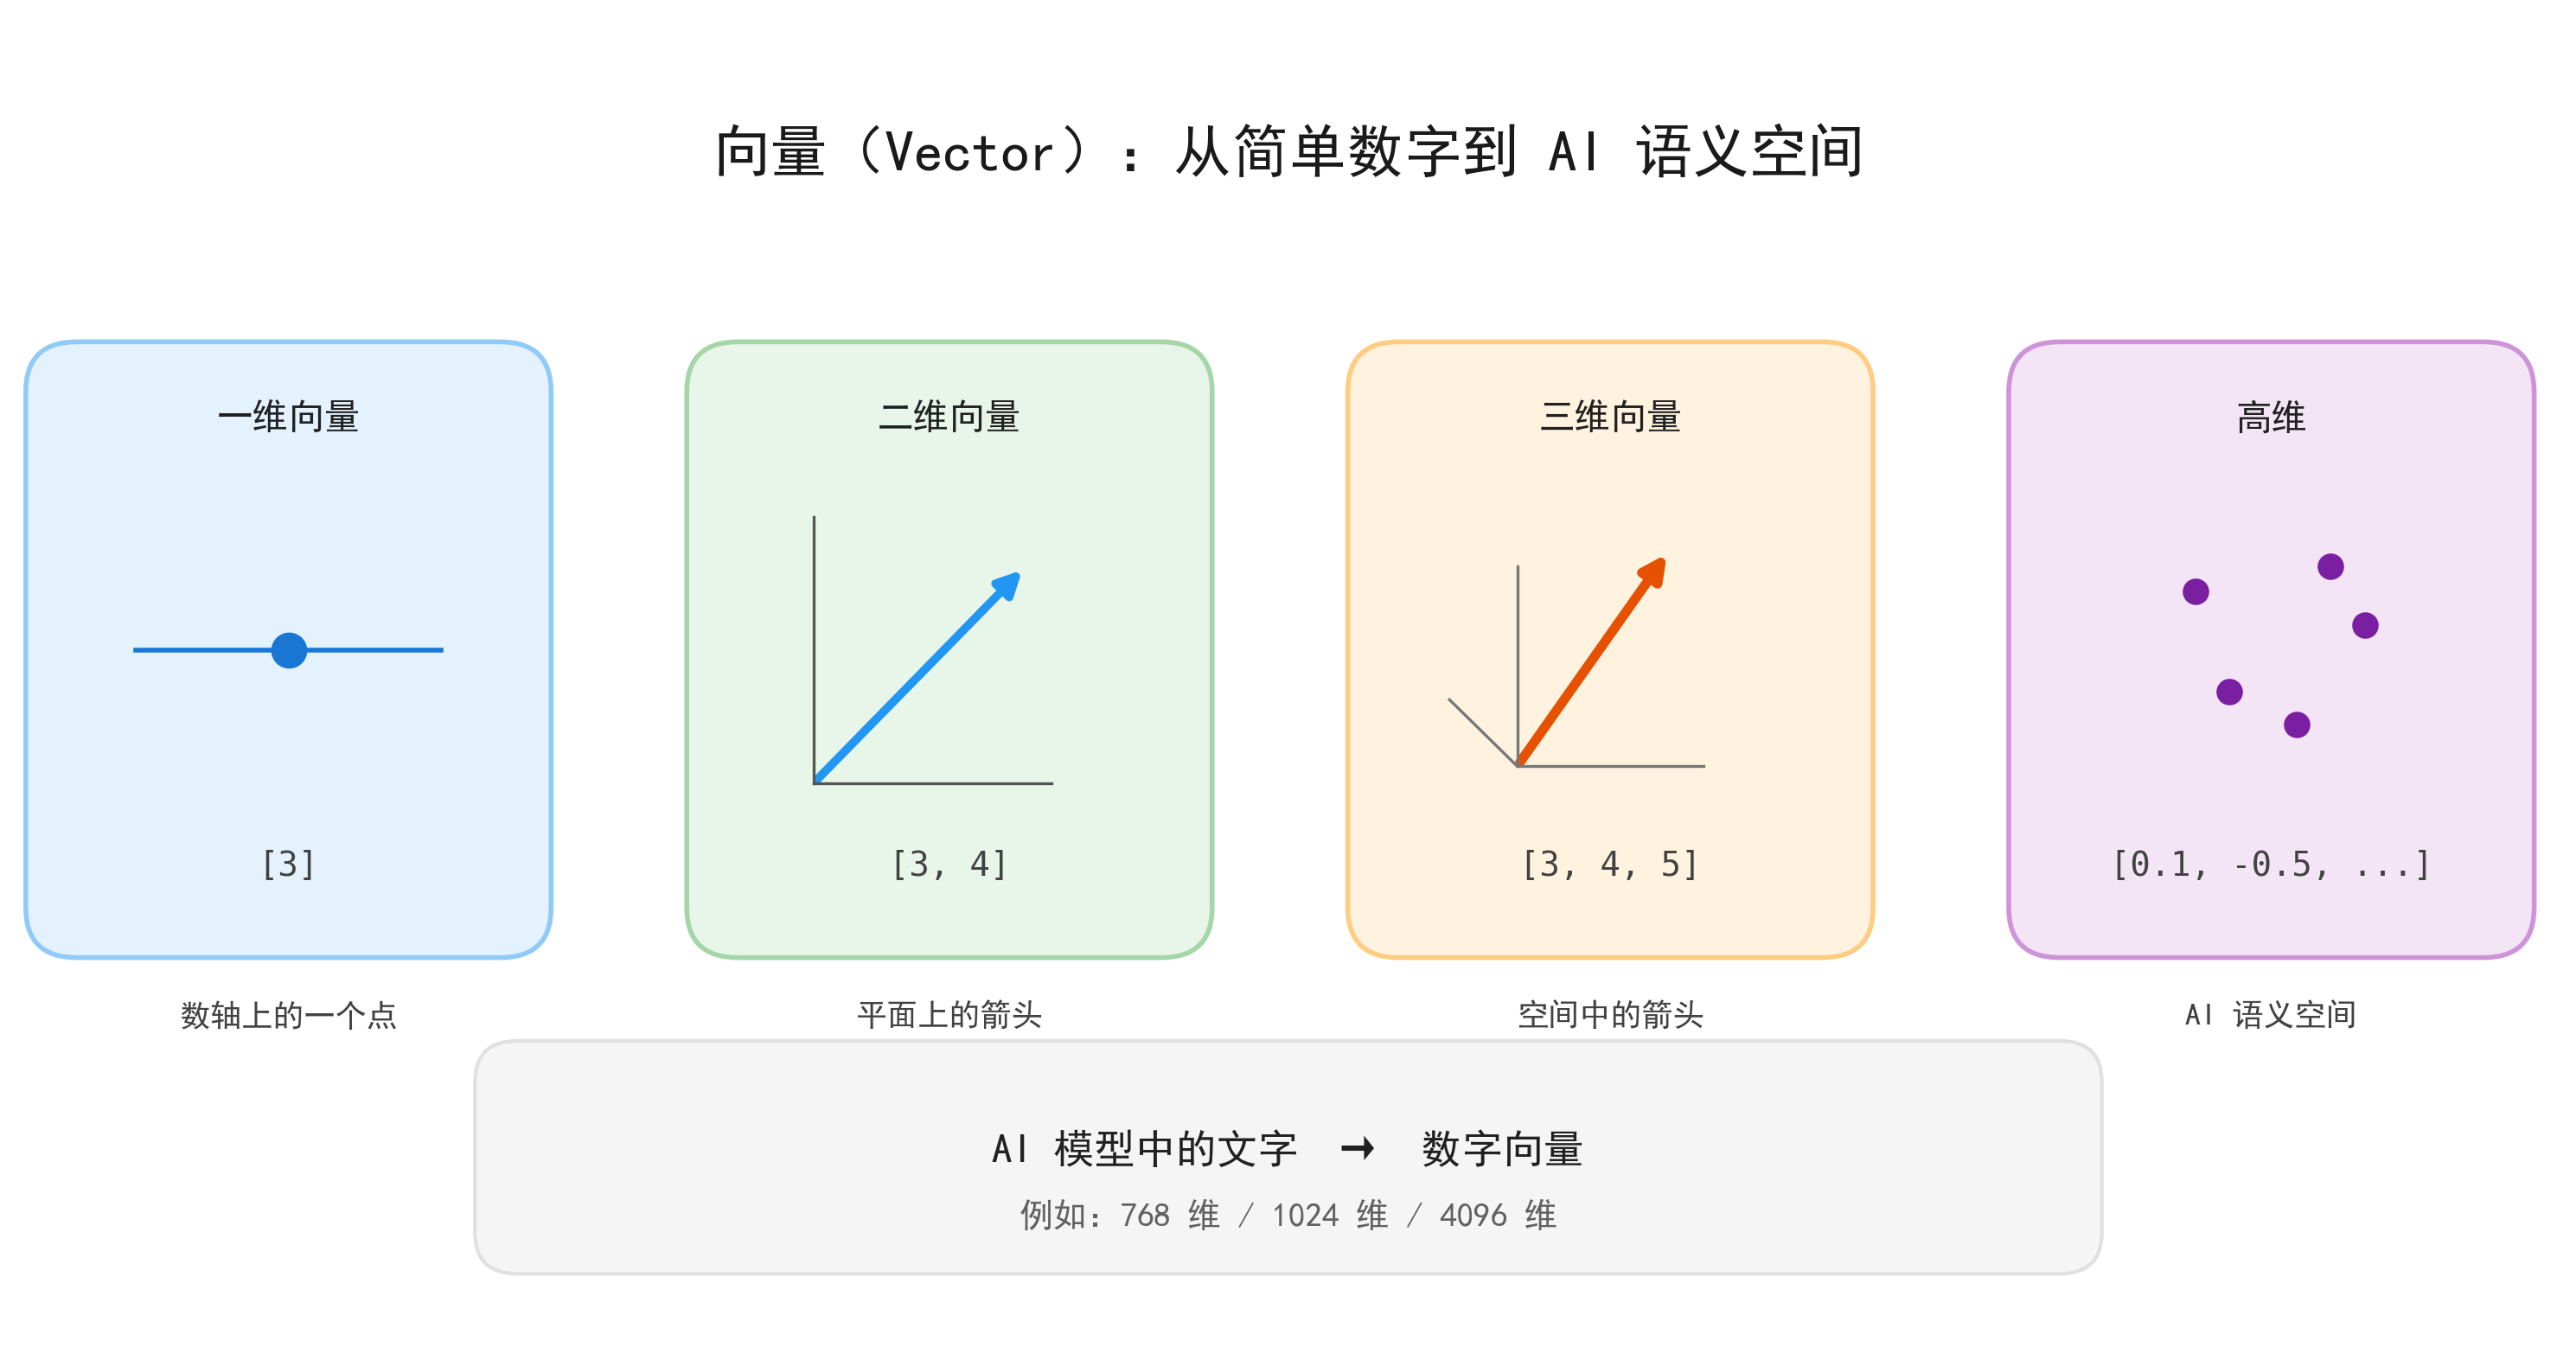
什么是向量?
向量 = 既有大小又有方向的量
你可以把向量想象成从一个点指向另一个点的箭头
一维:  [3]                    → 数轴上的一个点
二维:  [3, 4]                 → 平面上的一个箭头
三维:  [3, 4, 5]              → 空间中的一个箭头
高维:  [0.1, -0.5, 0.8, ...]  → AI 模型中的"语义向量"(通常是 768、1024、4096 维)
坐标系与嵌入空间(Embedding Space)
语义怎么编码?
坐标系是给向量一个"地址"的参照框架
| 坐标系类型 | 维度 | 用途 |
|---|---|---|
| 数轴 | 1D | 温度、时间 |
| 直角坐标系 | 2D/3D | 图形、物理 |
| 高维语义空间 | 768D+ | AI 的词向量表示 |
词嵌入(Word Embedding):从文字到向量
这是 AI 最核心的魔法之一:
"国王"  →  编码器  →  [0.2, -0.5, 0.1, 0.8, ..., 0.3]  (768维向量)
"女王"  →  编码器  →  [0.2, -0.5, 0.1, 0.7, ..., 0.4]
"苹果"  →  编码器  →  [-0.3, 0.8, -0.2, 0.1, ..., -0.5]
核心性质:语义相近的词,在向量空间中距离更近。
著名的类比关系:向量算术
在训练良好的词向量空间中,存在这样的关系:
向量("国王") - 向量("男人") + 向量("女人") ≈ 向量("女王")
这意味着向量空间编码了语义关系!方向代表了"性别”,距离代表了"概念相似度"。
余弦相似度(Cosine Similarity)
实际应用中,我们用余弦相似度来衡量两个向量的相似程度:
cos(θ) = (A · B) / (|A| × |B|)
取值范围:[-1, 1]
1:完全相同方向(语义完全一致)0:正交(语义无关)-1:完全相反方向(语义相反)
从向量到 Transformer(简要桥梁)
模型怎么处理向量?
自注意力机制(Self-Attention)的向量视角
Transformer 的核心是自注意力机制,它可以被理解为:
每个词向量都在问:“我应该关注其他哪些词?”
计算过程:
- 每个词向量生成三个新向量:Query(查询)、Key(键)、Value(值)
- 用 Q 和 K 的点积 计算注意力分数(“我有多关注你”)
- 用注意力分数加权聚合 Value,得到新的词表示
注意力分数(Q, K) = Q · K / √d
这里的点积,就是我们第二章讲的向量运算!
位置编码(Positional Encoding)
因为 Transformer 本身没有"顺序"概念,所以需要给每个词向量加上位置信息:
最终输入 = 词向量 + 位置向量
位置编码通常使用正弦/余弦函数,确保模型能感知"第几个词"。
简单的理解,你的输入提示词会被大模型转换为对应的向量,被它代入它的坐标系里进行黑盒运算,最后输出你需要的tokens
指令微调与RLHF
模型为什么能听懂指令?
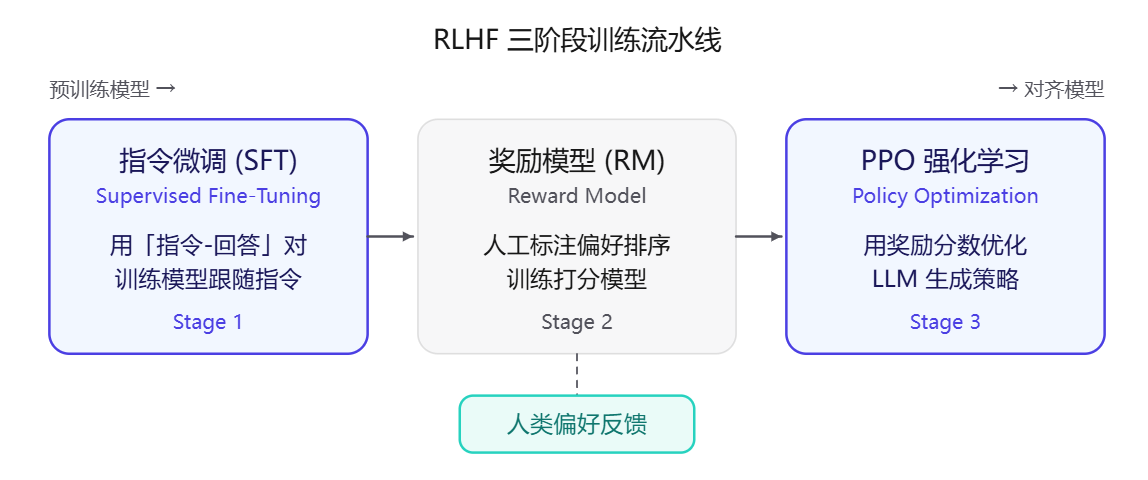
一个只会预测下一个 token 的概率拟合器,是怎么变成"听话的助手"的?接下来需要了解的就是**指令微调(SFT)**和 RLHF
指令微调(SFT)
指令微调的做法很直接:准备大量**「指令-回答」配对数据**,比如:
- 指令:“用 Python 写一个端口扫描脚本”
- 回答:
import socket\n...
用这些数据对预训练模型做监督学习,让模型学会一件事:看到指令格式,就切换到"执行任务"模式,而不是继续续写。
SFT 之后的模型已经能听懂指令了。但还有一个问题:它可能回答得"对"但不"好"。比如同一个问题,模型可以给出一个技术上正确但冗长、不友好、甚至带有安全风险的回答,也可以给出一个简洁、安全、结构清晰的回答。SFT 无法区分这两种回答的质量差异
而这就是RLHF要解决的问题
RLHF(Reinforcement Learning from Human Feedback)
RLHF的目的就是为了让模型对齐人类偏好
Stage 1 — SFT:就是上面说的指令微调,作为 RLHF 的起点。这一步让模型"能听懂话"
Stage 2 — 奖励模型(Reward Model)训练:让人类标注员对模型生成的多个回答进行偏好排序。比如同一个问题,模型生成了 A、B、C 三个回答,标注员认为 A > B > C。用这些排序数据训练一个独立的"打分模型"——它接收一段「指令+回答」,输出一个标量分数,分数越高代表越符合人类偏好
Stage 3 — PPO 强化学习:把 SFT 模型作为初始策略,让它生成回答,用奖励模型给回答打分,然后用 PPO(近端策略优化)算法根据分数调整模型参数。分数高的行为被强化,分数低的行为被抑制。 这个过程会迭代多轮,模型逐渐学会以人类更喜欢的方式回答
经过这三步,模型不仅会听指令,还会以人类偏好的方式回答——更简洁、更安全、更有用、更倾向于结构化输出
拓展:
DPO(Direct Preference Optimization)。RLHF 的 Stage 2+3 流程复杂、训练不稳定,DPO 跳过奖励模型,直接用偏好数据优化 LLM,近两年被广泛采用(Llama 3、Zephyr 等模型都用了),因流程更简单而逐渐成为 RLHF 的主流替代方案。
RLHF 的局限性:
模型可能学会"讨好"奖励模型而非真正提升质量,可能在安全对齐后变得过于保守,拒绝合理请求。
指令微调和RLHF与提示词工程有什么关系?
SFT和RLHF解释了前文那些提示词技巧为什么有效。
例如角色设定(“你是一位资深工程师”)之所以管用,是因为模型在指令微调阶段见过大量类似格式的训练样本,形成了对这类输入的条件反射。模型会主动加免责声明、倾向于用 Markdown 表格而非纯文本输出、拒绝有害请求——这些行为模式都是 RLHF 训练出来的偏好,而非模型"天生如此"。
换句话说,提示词工程的所有技巧,本质上都是在利用微调后模型已建立的行为模式。你的指令越接近训练数据中的格式,输出质量越高;偏离训练分布的提示词,效果会明显下降。
LLM生成Token的完整分布原理
模型怎么生成回答?
Step 1 — 上下文向量化嵌入(Embedding) 用户输入+对话历史 → 每个Token转为高维实数向量。
核心思想:“给Token贴语义标签,语义越相近,向量距离越近。” 例:猫/猫咪向量相似度 > 猫/电脑。
Step 2 — 多头注意力全局建模 模型扫描之前所有向量,计算每个Token之间的关联权重:
- 关键关联:代词指代、逻辑转折、长距离因果关系
- 输出:融合全局上下文的深层特征向量
Step 3 — 归一化&前馈网络提纯 多层线性变换+激活函数——强化关键语义、过滤噪声、锁定续写逻辑倾向。
Step 4 — 输出概率分布计算(最关键) 特征向量映射到词汇表维度,softmax归一化产生所有候选Token的概率排名。
- 范围:0–1,总和为1
- 示例:“春天来了,万物___” → 生长(0.82), 复苏(0.15), 凋零(0.03)
Step 5 — 采样解码选Token,循环生成 从概率表按策略选一个Token,追加到上下文,循环到Step 1直到停止Token。
3种采样策略:
- 贪心采样 (Greedy):总选最高概率Token → 非常流畅,机械式重复
- Top-K采样:从最高K个高概率Token中随机选 → 有一定创造性,偶尔胡说
- Top-P(Nucleus Sampling):概率从高到低累加,凑够阈值 P 就圈出“核”随机选 → 候选数自适应,多样又靠谱,当前最主流
实际部署中,Top-K 和 Top-P 通常组合使用:先通过 Top-K 截断极长的 Token 长尾提升计算效率,再用 Top-P 做动态筛选,兼顾生成质量与性能。
采样策略会和**温度系数(Temperature)**配合使用:温度越高,概率分布越平坦,随机性越强;温度越低,分布越尖锐,效果越接近贪心采样
常见现象解释:
- 为什么会幻觉? “不是记错,是概率优先通顺而不一定是事实”——高概率虚假序列被选中。
- 算力去了哪里? 注意力权重矩阵计算+海量逐Token生成——无法一次性输出全文。
- 为什么生僻字容易出错? 预训练数据有限,对应Token概率极低,采样几乎命中不了。
核心总结:它接受你的输入,基于训练数据来预测下一个可能出现的令牌(token)——每次预测基于前一个,形成连贯文本序列。
提示词工程的本质作用:通过特定文本构造引导LLM计算期望的Token序列。绝非单次的’提问’,而是一个包含设计、调试、优化、评估的闭环系统工程。
它被进一步描述为:“精心设计输入文本(即 Prompt),来约束模型的行为”——根本目标是"消除歧义"并使概率计算与人类意图对齐。
影响提示词效果的因素:
- 模型底层特性:架构、参数量、训练数据领域和版本
- 工程配置参数:Temperature、Top-K/Top-P采样、最大生成长度
- 文本表达艺术:用词准确性、语气匹配、指令结构
- 上下文语境:输入的逻辑连贯性、背景信息丰富度
警告:“不恰当的提示词"可能导致上下文窗口混乱、逻辑链断裂或语义歧义。
系统化迭代优化(4步,类比控制/软件工程):
- 需求定义:明确输出格式、内容边界、质量标准
- 初始设计:构建基础提示词框架,含指令、上下文、示例
- 迭代调试:反向分析无效输出,调整关键词、重构句子、添加约束
- 量化评估:建立指标,比较提示词版本间稳定性
总结引用:“提示词工程不仅是文本创作,更是对模型计算逻辑的精准干预与控制。”
关键参数配置讲解
我们该怎么控制生成过程?
温度(Temperature)
控制Token选择的随机性。越低=越确定性;越高=越发散/创造性。
- Temperature 0:始终选最高概率Token,确定性结果
- 更高温度:在预测中随机选择,结果多样化
- 创意任务:建议更高温度
- 精确任务:建议更低温度
Top-K与Top-P
限制Token预测范围的两种方法,影响随机性/多样性。
- Top-K:从K个最高概率Token中选择
- Top-P:从最高概率Token中选择,直到累积概率≥P值
- K或P越高=输出越有创意
- 精确任务:更小的K或更小的P
输出长度Max length
控制文本生成长度限制,影响计算资源和响应时间。
- 限制max_tokens是强制截断方式
- 不会自动使输出更简洁
- 必须在提示词中明确指定简洁要求
- 过度输出增加能耗和响应时间
Stop Sequences
通过阻止模型生成特定 token,来控制响应长度和结构。你预先定义的一组字符串,当模型生成的文本中出现了其中任何一个,模型就立即停止生成。
例如
# OpenAI API 示例
response = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "列出三种水果"}],
    stop=["\n\n", "注意", "```"]   # ← 这就是 stop sequences
)
模型生成: “苹果、香蕉、橙子\n\n接下来我再说点别的…” ↑ 检测到 stop sequence “\n\n” → 立即截断,返回 “苹果、香蕉、橙子”
- 匹配是精确子串匹配,不是语义匹配。
"stop"会匹配到"stop"但不会匹配到"Stop"(大小写敏感)。 - stop sequence 本身不会出现在返回结果中。它被检测到后,生成立即终止,该序列被丢弃。
- 它在 token 级别 进行检测。模型每生成一个 token,就检查当前累积文本的末尾是否匹配了某个 stop sequence
Frequency Penalty频率惩罚
根据一个 token 在已生成文本中出现的次数 来施加惩罚。出现次数越多,惩罚越重
在每一步生成时,模型对词表中每个 token 计算 logit。Frequency Penalty 的干预方式是:
$\text{logit}_i’ = \text{logit}_i - \alpha \times \text{count}(i)$
其中:
- $\text{logit}_i$:$token_i$的原始分数
- $\alpha$:你设置的
frequency_penalty值 - $\text{count}(i)$:$token_i$ 在已生成文本中出现的次数
关键特性:
- 累进式惩罚:出现 1 次扣 1 份,出现 5 次扣 5 份,出现 10 次扣 10 份。惩罚力度线性增长。
- 正值(> 0):抑制重复,鼓励用词多样性
- 负值(< 0):反向操作!鼓励模型重复使用已出现的词(极少使用)
- 0:不做任何干预
| 场景 | 建议值 | 原因 |
|---|---|---|
| 创意写作 / 诗歌 | 0.5 ~ 1.5 | 避免反复使用相同意象和词汇 |
| 代码生成 | 0 ~ 0.3 | 代码中变量名、关键字天然需要重复,惩罚太重会出错 |
| 技术文档 | 0 ~ 0.2 | 术语需要反复出现,不宜过度惩罚 |
| 头脑风暴 / 发散思维 | 1.0 ~ 2.0 | 强力推动模型探索新词汇 |
| 翻译任务 | 0 ~ 0.3 | 忠实原文,某些词就该重复 |
Presence Penalty(存在惩罚)
Presence Penalty 只看一个 token 是否出现过,不管出现了几次。只要出现过,就施加固定的一次性惩罚
$\text{logit}_i’ = \text{logit}_i - \beta \times \mathbb{1}[\text{count}(i) > 0]$
其中:
- $\beta$:你设置的
presence_penalty值 - $\mathbb{1}[\text{count}(i) > 0]$:指示函数,只要 $token_i$ 出现过(哪怕只出现 1 次),值就是 1;没出现过就是 0
关键特性
- 二值惩罚:要么扣,要么不扣,没有中间地带。出现 1 次和出现 100 次,惩罚完全相同。
- 正值(> 0):鼓励模型引入新话题、新概念
- 负值(< 0):允许模型围绕已有话题深入(极少使用)
- 它更像是一个"话题拓展器”,而不是"重复抑制器"
| 场景 | 建议值 | 原因 |
|---|---|---|
| 需要覆盖多个要点的文章 | 0.5 ~ 1.5 | 推动模型谈及更多不同方面 |
| 深度分析单一问题 | 0 ~ 0.2 | 允许模型反复使用核心术语深入讨论 |
| 对话系统 | 0.3 ~ 0.8 | 让回复不至于总是围绕同一个词转 |
| 法律/医学文本 | 0 ~ 0.1 | 专业术语必须反复出现 |
核心对比——Frequency Penalty vs Presence Penalty
| 维度 | Frequency Penalty | Presence Penalty |
|---|---|---|
| 惩罚依据 | token 出现的次数 | token 是否出现过(二值) |
| 惩罚公式 | $-\alpha \times \text{count}$ | $-\beta \times 1[\text{count} > 0]$ |
| 出现 1 次 | 扣 $\alpha \times 1$ | 扣 $\beta \times 1$ |
| 出现 3 次 | 扣 $\alpha \times 3$ | 扣 $\beta \times 1$(一样!) |
| 出现 10 次 | 扣 $\alpha \times 10$ | 扣 $\beta \times 1$(还是一样!) |
| 核心作用 | 抑制高频重复(治复读机) | 鼓励话题多样性(拓展新内容) |